LangChain vs LangGraph vs LangSmith - różnice i przykłady
LangChain, LangGraph i LangSmith często występują razem, ale rozwiązują różne problemy. Zobacz, czym się różnią, jak współpracują i kiedy warto użyć każdego z nich.
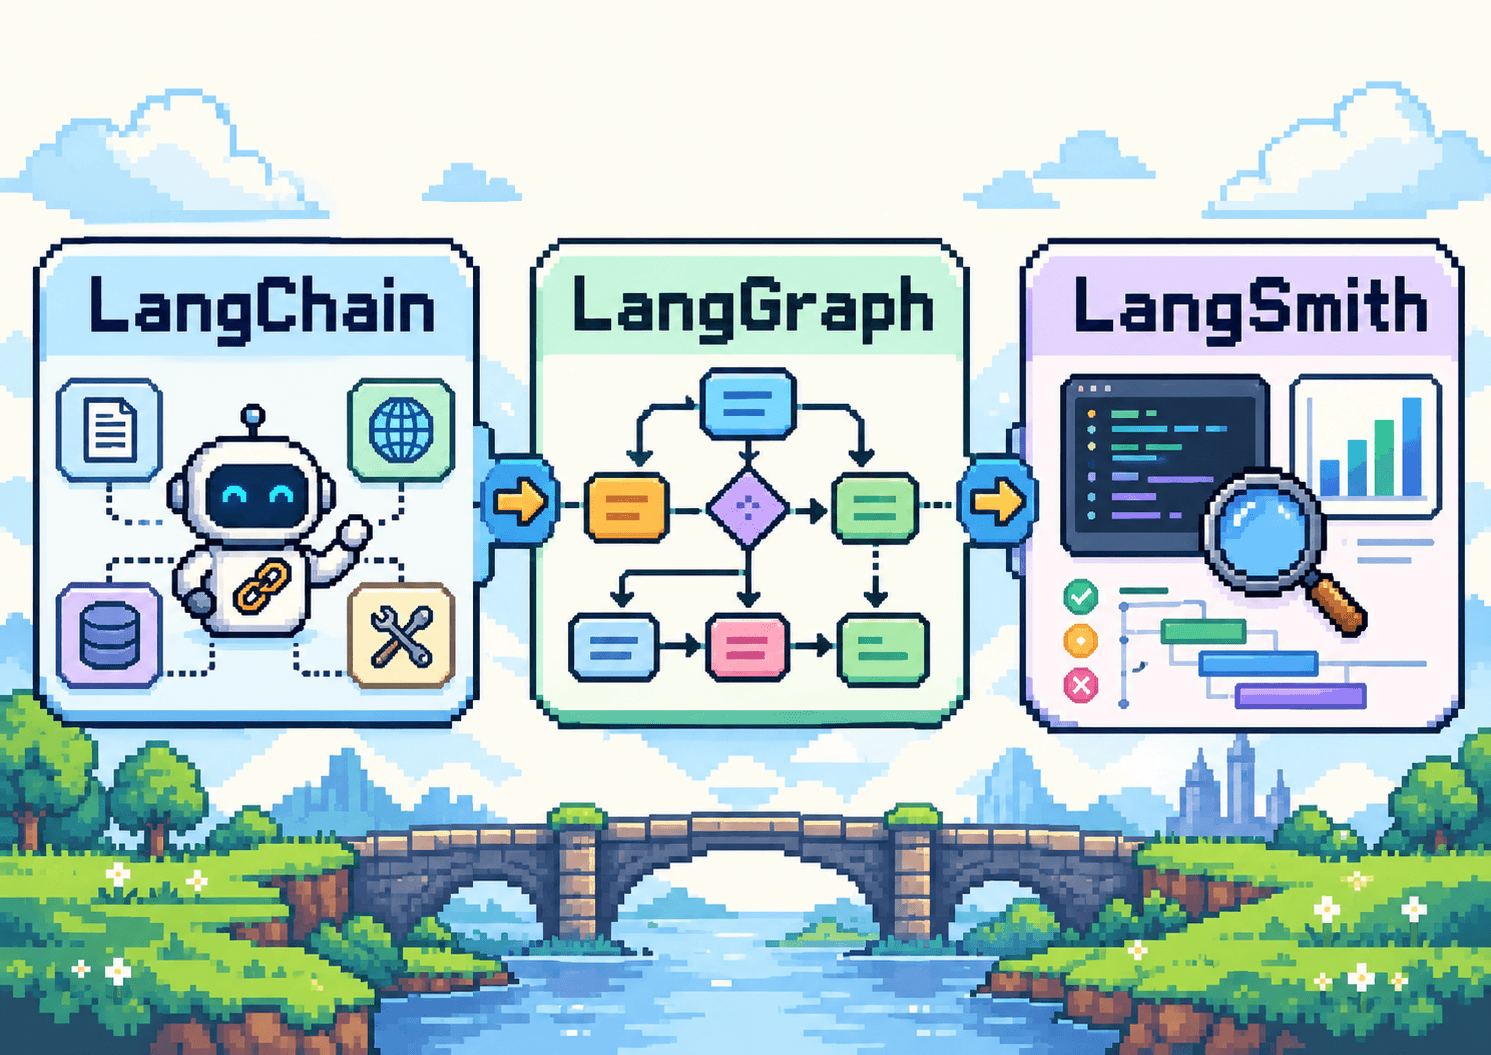
Table of contents
In brief
Key takeaways
- LangChain upraszcza budowanie agentów i łączenie modeli z narzędziami, promptami oraz zewnętrznymi źródłami danych.
- LangGraph daje większą kontrolę nad stanem, routingiem, pętlami i kolejnymi krokami bardziej złożonego workflow.
- Agenci tworzeni obecnie przez LangChain za pomocą create_agent() są zbudowani na LangGraphie.
- LangSmith służy do tracingu, debugowania, monitorowania i ewaluacji aplikacji wykorzystujących LLM-y.
- Nie każda aplikacja AI potrzebuje całego stacku - warto zaczynać od najprostszego rozwiązania, które faktycznie rozwiązuje problem.
W poprzednim artykule pokazałem, czym jest agent AI i czym różni się od zwykłego chatbota.
Wiemy już, że agent może nie tylko generować tekst, ale również korzystać z narzędzi, pobierać dane, wykonywać kod i na podstawie wyników decydować, co zrobić dalej.
Kiedy jednak zaczynamy budować taki system samodzielnie, szybko pojawiają się kolejne pytania.
Jak połączyć model z narzędziami? Jak kontrolować kolejne kroki? Gdzie przechowywać stan aplikacji? Co zrobić, jeśli jeden z etapów się nie powiedzie? I w końcu - jak sprawdzić, dlaczego agent zachował się w określony sposób?
I właśnie tutaj bardzo szybko trafimy na trzy nazwy:
- LangChain
- LangGraph
- LangSmith
Na pierwszy rzut oka może się wydawać, że są to trzy konkurencyjne biblioteki.
W praktyce rozwiązują jednak różne problemy i bardzo często wykorzystuje się je razem.
LangChain, LangGraph i LangSmith w skrócie
Najprościej zapamiętać:
LangChain - budujemy
LangChain pomaga zbudować agenta i połączyć model z narzędziami, promptami oraz pozostałymi elementami naszej aplikacji.
LangGraph - sterujemy
LangGraph pozwala dokładniej kontrolować przepływ aplikacji - jej stan, kolejne kroki, rozgałęzienia, pętle czy miejsca wymagające decyzji człowieka.
LangSmith - obserwujemy i testujemy
LangSmith pozwala zobaczyć, co faktycznie wydarzyło się podczas działania aplikacji. Pomaga w debugowaniu, tracingu, monitorowaniu i testowaniu jakości.
Możemy więc zapamiętać:
LangChain BUILD
LangGraph ORCHESTRATE
LangSmith OBSERVE + EVALUATE
Nie są to jednak trzy całkowicie osobne światy.
W aktualnym LangChain agenci tworzeni za pomocą create_agent() są zbudowani właśnie na LangGraphie. LangChain daje nam wyższy poziom abstrakcji, natomiast LangGraph pozwala zejść niżej i dokładniej kontrolować działanie systemu.
LangSmith możemy natomiast wykorzystać do obserwowania i testowania aplikacji zbudowanej przy użyciu jednego lub drugiego.
Aktualna dokumentacja LangChain dokładnie tak rozdziela ich role: create_agent() służy jako konfigurowalny mechanizm agenta, LangGraph jako niskopoziomowa warstwa orkiestracji, a LangSmith jako narzędzie do tracingu, debugowania i ewaluacji.
W chwili pisania artykułu korzystam z wersji:
LangChain 1.4.6
LangGraph 1.2.16
LangSmith SDK 0.14.11
Czym jest LangChain?
Zacznijmy od najwyższego poziomu.
LangChain pomaga nam połączyć model AI z resztą aplikacji.
Sam model możemy wywołać bez żadnego frameworka.
Na przykład korzystając bezpośrednio z API OpenAI czy też Anthropic API.
Problem zaczyna się wtedy, kiedy model ma zrobić coś więcej niż tylko odpowiedzieć na prompt.
Chcemy, żeby mógł:
- wyszukać informacje,
- pobrać dane z bazy,
- użyć RAG-u,
- wykonać obliczenia,
- wywołać zewnętrzne API,
- uruchomić funkcję w Pythonie,
- albo wybrać jedno z kilku dostępnych narzędzi.
LangChain daje nam gotowe elementy, które pomagają połączyć te części.
W dużym uproszczeniu:
MODEL + PROMPT + TOOLS + LOGIKA AGENTA
Jednym z najważniejszych elementów aktualnego API jest:
create_agent()
To właśnie od niego zaczniemy.
Prosty agent w LangChain
Załóżmy, że tworzymy prostego asystenta sklepu internetowego.
Chcemy, żeby potrafił odpowiedzieć na pytania dotyczące:
- dostawy,
- zwrotów.
Instalujemy LangChain:
pip install -U langchain
Następnie tworzymy dwie zwykłe funkcje:
from langchain.agents import create_agent

def get_shipping_info(country: str) -> str:
    """Sprawdza informacje o dostawie."""

    if country.lower() == "polska":
        return "Dostawa trwa 1-2 dni robocze i kosztuje 15 zł."

    return "Dostawa zagraniczna trwa 3-7 dni roboczych."


def get_return_policy() -> str:
    """Zwraca informacje dotyczące zwrotów."""

    return "Produkt można zwrócić w ciągu 14 dni."
Na tym etapie nie dzieje się jeszcze nic związanego z AI.
To zwykłe funkcje w Pythonie.
Dopiero teraz przekazujemy je agentowi:
agent = create_agent(
    model="openai:gpt-5.5",
    tools=[
        get_shipping_info,
        get_return_policy,
    ],
    system_prompt=(
        "Jesteś asystentem sklepu internetowego. "
        "Korzystaj z dostępnych narzędzi, jeśli ich potrzebujesz."
    ),
)
I zadajemy pytanie:
result = agent.invoke(
    {
        "messages": [
            {
                "role": "user",
                "content": "Ile mam czasu na zwrot produktu?",
            }
        ]
    }
)

print(result["messages"][-1].content_blocks)
Najciekawsze jest jednak to, czego tutaj nie napisaliśmy.
Nie mamy:
if "zwrot" in question:
    get_return_policy()
Nie wskazujemy modelowi bezpośrednio:
Teraz uruchom funkcję get_return_policy().Agent zna dostępne narzędzia i sam może zdecydować, czy któregoś z nich potrzebuje.
Co dzieje się pod spodem?
W uproszczeniu:
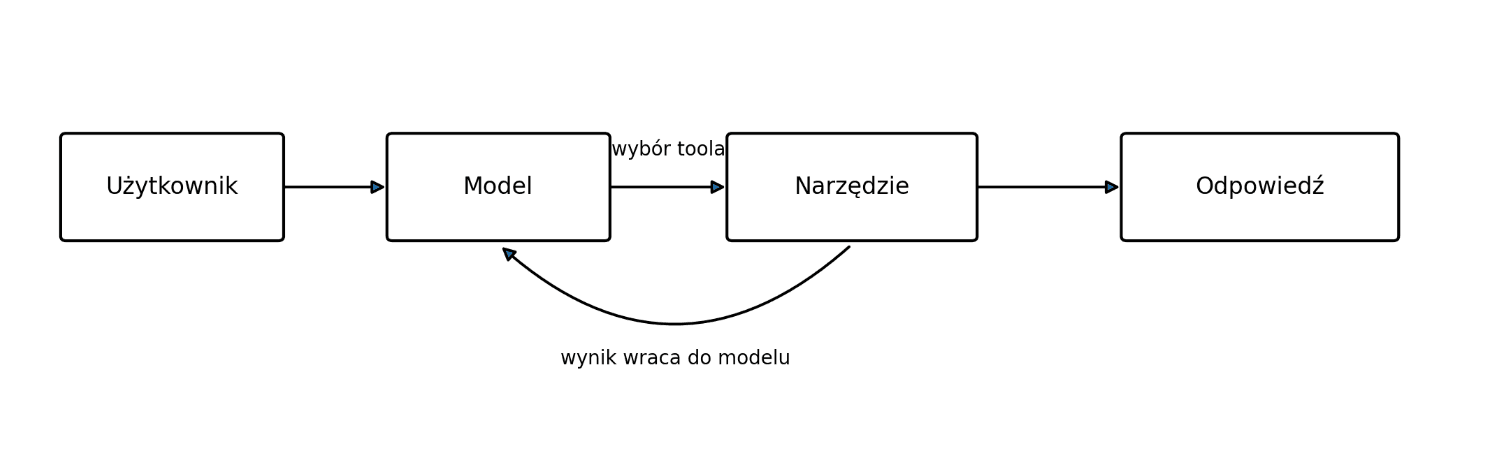
Czyli opisując graf:
Użytkownik
↓
Model
↓
potrzebuję narzędzia?
↓
Tool
↓
Wynik
↓
Model
↓
Odpowiedź
Agent może również wykonać kilka kroków.
Model
↓
Tool A
↓
Model
↓
Tool B
↓
Model
↓
Odpowiedź
To już przypomina pętlę działania agenta, o której pisałem szerzej w artykule Agent AI to nie chatbot. Co potrafi zrobić sam?.
Tutaj LangChain po prostu daje nam gotową warstwę, która pomaga taki mechanizm zbudować.
Kiedy LangChain ma sens?
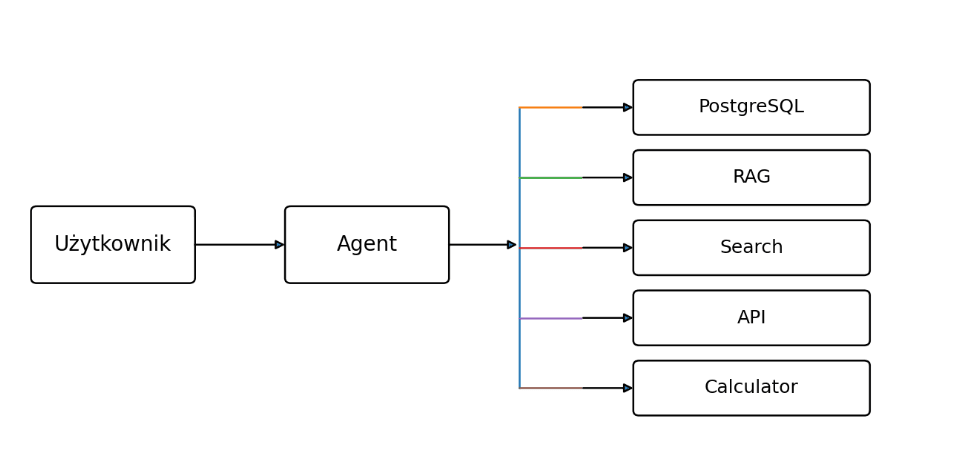
Wyobraźmy sobie agenta finansowego.
Ma dostęp do:
PostgreSQLRAGkalkulatorawyszukiwarkiAPI bankowego
Użytkownik pyta:
Ile wydałem na jedzenie w ostatnich trzech miesiącach i czy moje wydatki rosną?
Agent może zdecydować, że najpierw potrzebuje danych z PostgreSQL.
Później może wykonać obliczenia.
Na końcu model przygotuje odpowiedź.
Może wyglądać to tak:
W takim przypadku LangChain jest bardzo wygodny.
Nie musimy na początku dokładnie projektować każdej możliwej ścieżki.
Dajemy agentowi dostęp do narzędzi i pozwalamy mu zdecydować, których potrzebuje.
Dlatego LangChain jest dobrym punktem startowym dla:
- agentów korzystających z tools,
- agentów RAG,
- agentów SQL,
- asystentów pracujących z dokumentami,
- agentów wykorzystujących zewnętrzne API,
- prostych systemów agentowych.
Ale wraz ze wzrostem aplikacji może pojawić się problem.
Co jeśli chcemy mieć większą kontrolę?
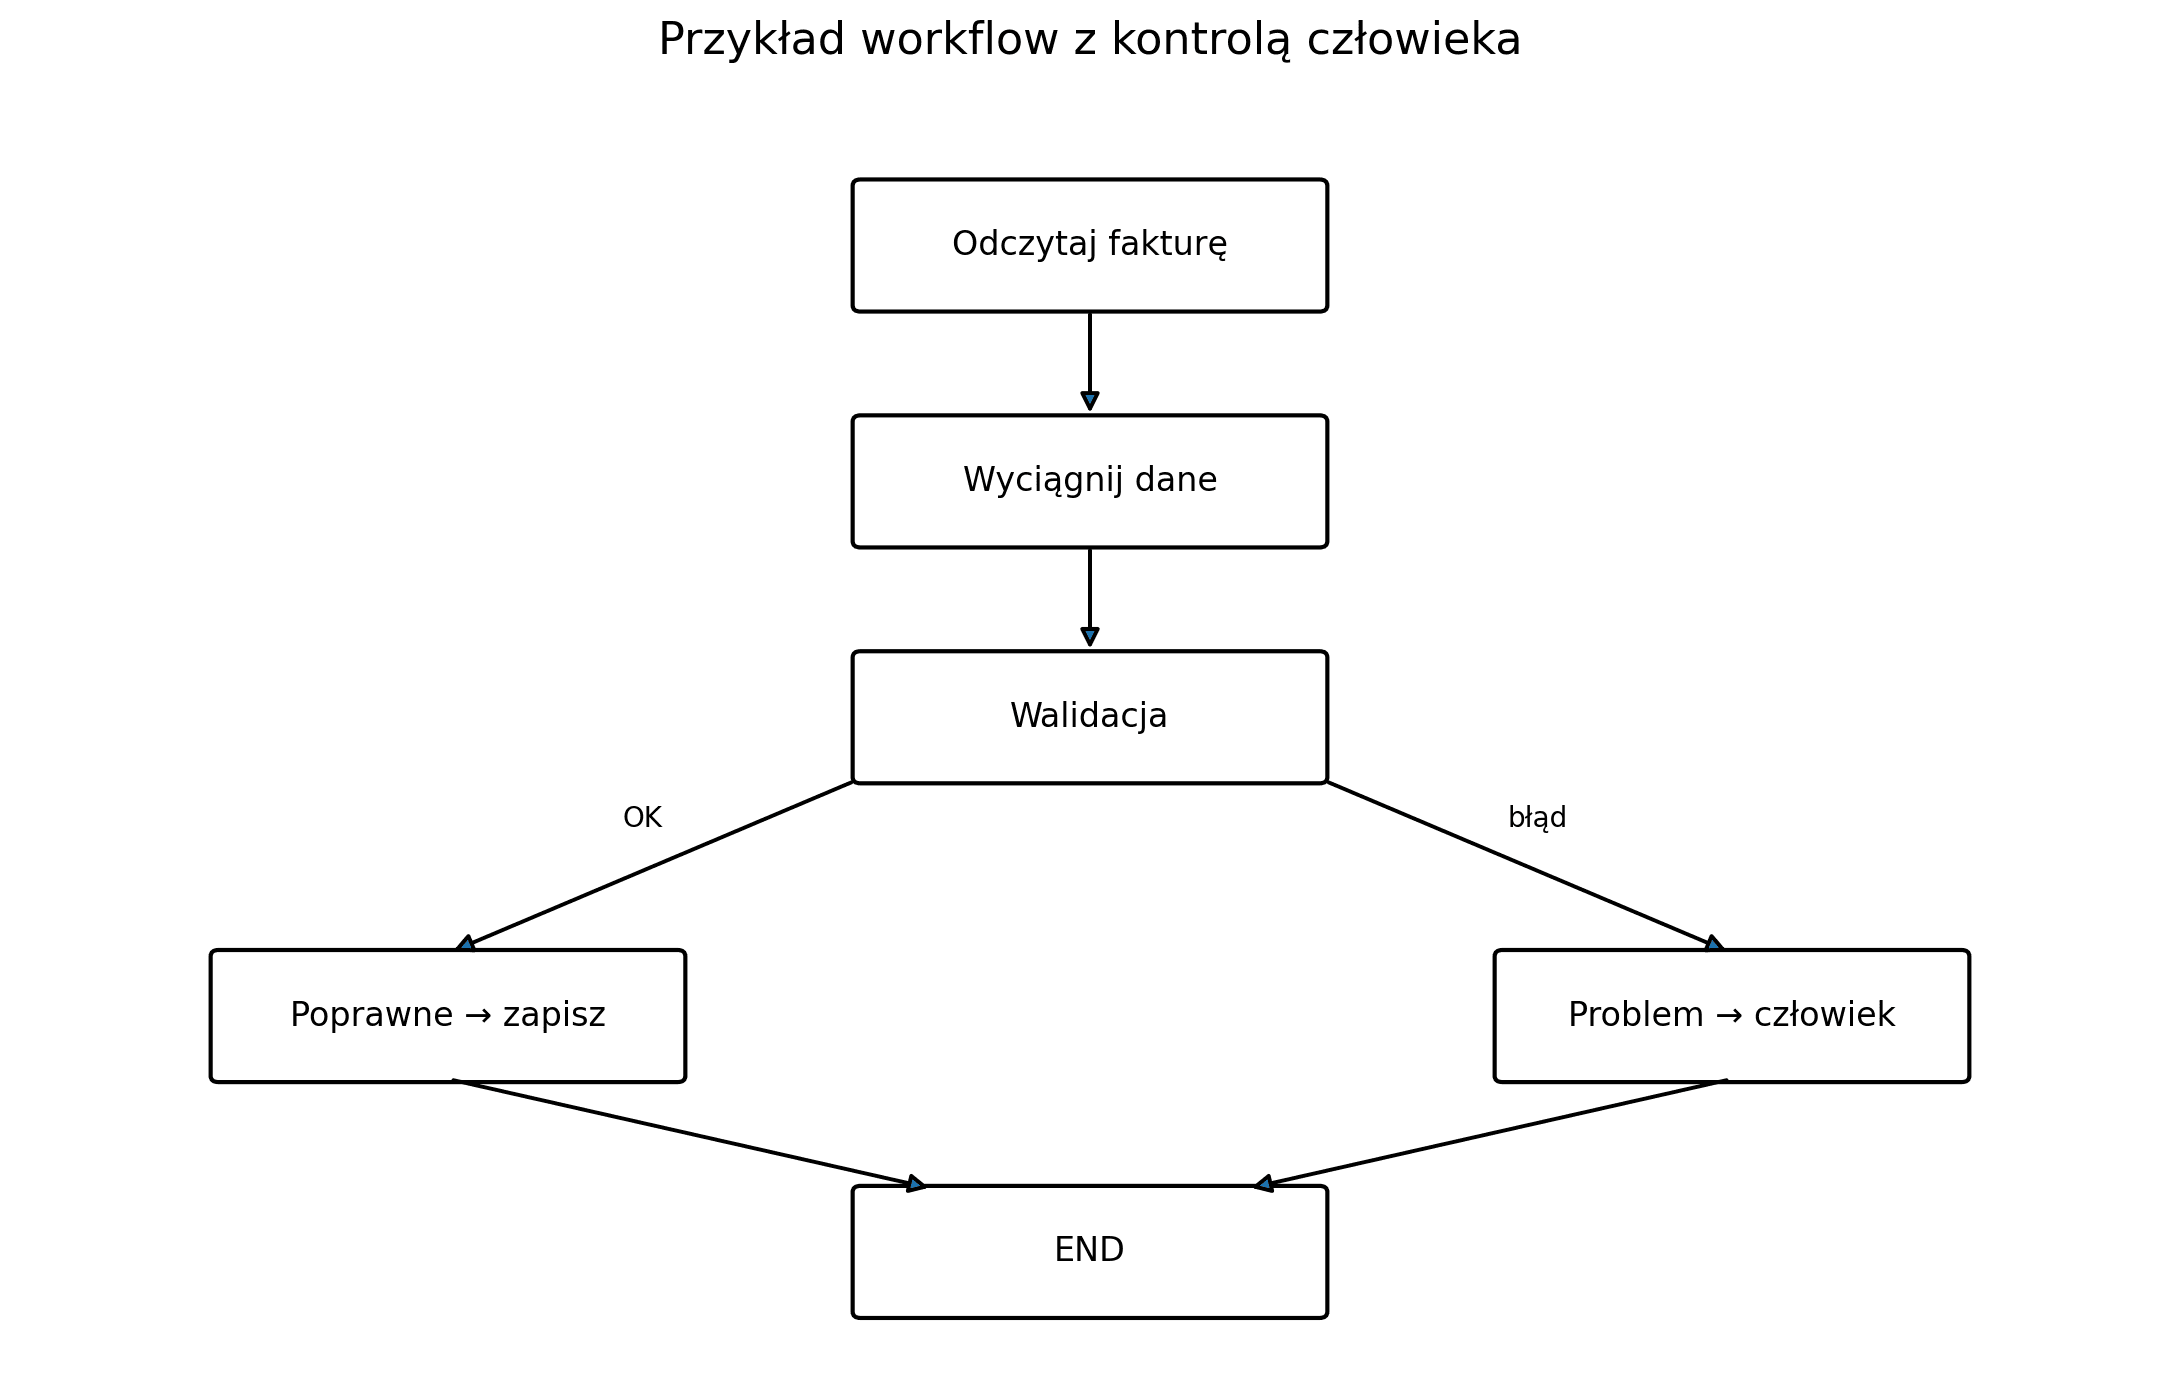
Załóżmy, że tworzymy system analizujący faktury.
Chcemy, żeby działał według konkretnego procesu:
- odczytaj dokument,
- wyciągnij dane,
- sprawdź poprawność,
- jeśli dane są poprawne - zapisz je,
- jeśli nie - spróbuj ponownie,
- jeśli nadal występuje problem - poproś człowieka o decyzję.
Nie chcemy tutaj powiedzieć agentowi:
Masz fakturę. Zrób z nią coś sensownego.
Chcemy sami zaprojektować proces.
W takim przypadku zaczyna przydawać się LangGraph.
Czym jest LangGraph?
LangGraph to framework do budowania i kontrolowania stanowych workflow oraz agentów jako grafu.
Zamiast patrzeć na aplikację jak na jednego agenta, zaczynamy widzieć ją jako serię połączonych ze sobą kroków.
Na przykład:
START
  ↓
pobierz dane
  ↓
analiza
  ↓
walidacja
 ↙       ↘
OK       ERROR
↓           ↓
zapisz     retry
Dużą zaletą LangGraph jest możliwość połączenia dwóch światów:
zwykłego kodu + LLM
Nie każda decyzja musi być podejmowana przez model.
Jeżeli jakiś krok możemy napisać jako zwykłe:
if amount > 10_000:
    require_approval()
nie musimy pytać modelu:
Czy Twoim zdaniem ta transakcja wymaga akceptacji?
I to jest bardzo ważne przy budowaniu systemów produkcyjnych.
Aktualna dokumentacja opisuje LangGraph jako niskopoziomowy framework i runtime pozwalający łączyć deterministyczne kroki napisane przez programistę z krokami sterowanymi przez LLM.
W świecie robotyki legendarna współpraca człowiek + maszyna.
Cztery elementy LangGraph
Na początku wystarczy zrozumieć cztery rzeczy.
1. State
State to dane przechowywane podczas działania naszego workflow.
Przykład:
{
    "question": "Ile mam czasu na zwrot?",
    "route": "returns",
    "context": "...",
    "answer": ""
}
Kolejne elementy grafu mogą odczytywać i aktualizować ten stan.
2. Node
Node to pojedynczy krok.
Może być nim:
funkcja w Pythoniewywołanie LLMagentRAGAPIwalidacja
Na przykład:
def get_return_policy(state):
    ...
3. Edge
Edge mówi:
Po wykonaniu tego kroku przejdź do następnego.
Na przykład:
START → router
albo:
answer → END
4. Conditional edge
Conditional edge pozwala wybrać różne ścieżki.
Na przykład ścieżkę pobrania informacji na temat dostawy, zwrotów lub informacji ogólnych.
I właśnie tutaj graf zaczyna robić się naprawdę przydatny.
Ten sam przykład w LangGraph
Wróćmy do naszego asystenta sklepu.
W LangChain daliśmy agentowi dwa narzędzia:
get_shipping_info()
get_return_policy()
i model sam decydował, którego użyć.
Teraz zrobimy to inaczej.
To my zaprojektujemy przepływ.
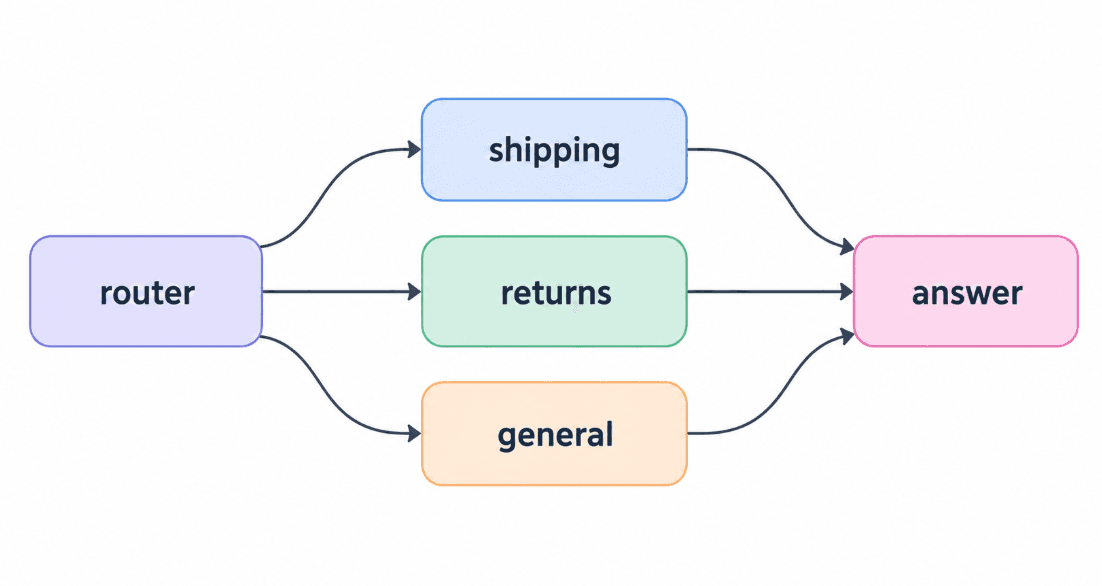
Najpierw definiujemy state:
from typing import Literal, TypedDict

from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, START, END


class SupportState(TypedDict):
    question: str
    route: str
    context: str
    answer: str
Następnie tworzymy router:
def router(state: SupportState):
    question = state["question"].lower()

    if "zwrot" in question:
        return {"route": "returns"}

    if "dostaw" in question:
        return {"route": "shipping"}

    return {"route": "general"}
Zwróć uwagę na jedną rzecz.
To nie jest LLM.
To zwykły Python.
W prostym przykładzie nie potrzebujemy modelu do podjęcia tej decyzji.
Dodajemy kolejne node'y:
def returns(state: SupportState):
    return {
        "context": "Produkt można zwrócić w ciągu 14 dni."
    }


def shipping(state: SupportState):
    return {
        "context": "Dostawa trwa 1-2 dni robocze."
    }


def general(state: SupportState):
    return {
        "context": "Brak dodatkowych informacji."
    }
Dla uproszczenia router korzysta tutaj ze zwykłych słów kluczowych. W prawdziwej aplikacji routing mógłby wykonywać również model LLM albo klasyfikator.
Teraz wykorzystujemy model dopiero tam, gdzie faktycznie go potrzebujemy:
model = init_chat_model("openai:gpt-5.5")


def answer(state: SupportState):
    response = model.invoke(
        f"""
        Odpowiedz klientowi krótko i konkretnie.

        Pytanie:
        {state["question"]}

        Informacje:
        {state["context"]}
        """
    )

    return {
        "answer": response.content
    }
Definiujemy możliwe ścieżki:
def choose_route(
    state: SupportState,
) -> Literal["shipping", "returns", "general"]:
    return state["route"]
I składamy cały graf:
builder = StateGraph(SupportState)

builder.add_node("router", router)
builder.add_node("shipping", shipping)
builder.add_node("returns", returns)
builder.add_node("general", general)
builder.add_node("answer", answer)

builder.add_edge(START, "router")

builder.add_conditional_edges(
    "router",
    choose_route,
    {
        "shipping": "shipping",
        "returns": "returns",
        "general": "general",
    },
)

builder.add_edge("shipping", "answer")
builder.add_edge("returns", "answer")
builder.add_edge("general", "answer")

builder.add_edge("answer", END)

graph = builder.compile()
Teraz możemy go wywołać:
result = graph.invoke(
    {
        "question": "Ile mam czasu na zwrot produktu?"
    }
)

print(result["answer"])
Kod jest dłuższy.
Ale zyskujemy coś bardzo ważnego:
dokładnie wiemy, jakie ścieżki może wykonać nasza aplikacja.
LangChain vs LangGraph - gdzie naprawdę jest różnica?
Tutaj dochodzimy do najważniejszej części artykułu.
W przykładzie LangChain powiedzieliśmy mniej więcej:
Masz model i kilka narzędzi. Sam zdecyduj, czego potrzebujesz.
W przykładzie LangGraph:
Najpierw wykonaj router. Później wybierz jedną z trzech ścieżek. Na końcu zawsze wygeneruj odpowiedź.
Czyli:
LangChain
daję agentowi możliwości
↓
agent wybiera działania
LangGraph
projektuję możliwe ścieżki
↓
system porusza się po grafie
To nie oznacza jednak, że LangChain daje agentowi pełną dowolność, a LangGraph wszystko blokuje.
LangChain czy LangGraph?
To pytanie pojawia się bardzo często.
Ale nie zawsze jest dobrze postawione.
Bo aktualnie:
LangChain sam wykorzystuje LangGraph pod spodem.
Agenci create_agent() korzystają z LangGraph między innymi dzięki możliwościom takim jak persistence, durable execution czy human-in-the-loop.
Możemy też zrobić własny większy workflow:
LANGGRAPH
   │
   |--- zwykła funkcja
   │
   |--- LangChain Agent
   │
   |--- walidacja
   │
   |--- API
   │
   |--- human approval
Czyli jednym z node'ów naszego grafu może być cały agent zbudowany w LangChain.
Dlatego często odpowiedzią nie jest:
LangChain czy LangGraph?
ale:
LangChain i LangGraph.
Co jeszcze daje LangGraph?
Nasz przykład jest bardzo prosty.
Prawdziwe workflow szybko robią się bardziej skomplikowane.
Załóżmy, że agent wykonuje zadanie przez kilka minut.
Po pięciu krokach coś się psuje.
Czy cały proces powinien zaczynać się od początku?
Albo agent przygotował operację wymagającą zgody człowieka.
System powinien:
zatrzymać się
↓
zapisać stan
↓
poczekać
↓
otrzymać decyzję
↓
kontynuować
LangGraph został zaprojektowany między innymi z myślą o takich przypadkach.
Dokumentacja wymienia funkcje takie jak:
- durable execution,
- persistence,
- human-in-the-loop,
- pamięć,
- długotrwałe workflow.
Dlatego zaczyna być szczególnie przydatny, kiedy aplikacja przestaje być prostym agentem z trzema tools i zaczyna przypominać prawdziwy proces biznesowy.
Gdzie pojawia się LangSmith?
Mamy już agenta.
Mamy graf.
A teraz dostajemy od użytkownika informację:
Agent odpowiedział źle.
No dobrze.
Ale dlaczego?
Czy źle zrozumiał pytanie?
Czy użył niewłaściwego narzędzia?
Czy tool zwrócił złe dane?
Czy RAG znalazł niewłaściwy dokument?
Czy prompt był źle napisany?
Czy problem pojawił się dopiero na ostatnim etapie?
Przy jednym wywołaniu modelu możemy jeszcze zrobić:
print(response)
Przy kilkunastu krokach robi się znacznie trudniej.
I tutaj pojawia się LangSmith.
Czym jest LangSmith?
Najprościej:
LangSmith pozwala zobaczyć, co faktycznie wydarzyło się podczas wykonywania aplikacji AI.
Możemy zobaczyć trace:
USER
↓
AGENT
↓
MODEL
↓
TOOL
↓
MODEL
↓
DATABASE
↓
MODEL
↓
ANSWER
wejść w każdy krok.
Możemy sprawdzić między innymi:
inputoutputtool callsstatetransitionslatencyerrors
Czyli zamiast zgadywać:
Chyba model źle wybrał narzędzie.
możemy zobaczyć rzeczywistą historię wykonania.
Aktualna dokumentacja LangChain opisuje LangSmith właśnie jako narzędzie pozwalające sprawdzać traces, tool calls, przejścia stanu i opóźnienia w jednym miejscu.
Jak włączyć LangSmith?
W aplikacji LangChain lub LangGraph podstawowy tracing możemy uruchomić przez zmienne środowiskowe:
LANGSMITH_TRACING=true
LANGSMITH_API_KEY="..."
LANGSMITH_PROJECT="my-ai-app"
Po uruchomieniu aplikacji kolejne wykonania możemy analizować w LangSmith.
Nie zmienia to logiki naszego agenta.
LangSmith znajduje się raczej obok aplikacji i obserwuje jej działanie.
LangSmith to nie tylko debugowanie
Druga ważna część LangSmith to evaluation.
Załóżmy, że budujemy RAG.
Mamy 100 pytań testowych.
Zmieniłem:
promptmodelembedding modelchunk sizeretriever
Otwieram aplikację i zadaję trzy pytania.
Wydaje się, że jest lepiej.
Ale czy rzeczywiście?
Przy aplikacjach opartych na LLM trudno polegać wyłącznie na takim ręcznym testowaniu.
Możemy zamiast tego stworzyć dataset i porównać:
WERSJA A
model A
prompt A
retriever A
vs.
WERSJA B
model B
prompt B
retriever B
na tych samych przykładach.
LangSmith daje narzędzia do takich ewaluacji i porównywania kolejnych wersji aplikacji.
Podsumowanie
LangChain, LangGraph i LangSmith często występują obok siebie, ale rozwiązują inne problemy.
LangChain pomaga nam szybko stworzyć agenta i połączyć model z narzędziami.
LangGraph daje większą kontrolę nad przepływem, stanem i kolejnymi krokami bardziej złożonego systemu.
LangSmith pozwala obserwować, debugować i testować to, co zbudowaliśmy.
Najprościej:
LangChain = buduję
LangGraph = steruję
LangSmith = obserwuję i testuję
Nie musimy jednak zaczynać od wszystkich trzech.
Warto zacząć możliwie prosto i dodawać kolejne warstwy dopiero wtedy, kiedy zaczynamy ich naprawdę potrzebować.
A jeśli nie czytałeś jeszcze pierwszej części i chcesz najpierw zrozumieć, dlaczego agent różni się od zwykłego chatbota, czym są tools i skąd bierze się autonomia systemów agentowych, znajdziesz ją tutaj:
Agent AI to nie chatbot. Co potrafi zrobić sam?
Common questions
Czym różni się LangChain od LangGraph?
LangChain daje wyższy poziom abstrakcji i pozwala szybko budować agentów korzystających z modeli i narzędzi. LangGraph służy do dokładniejszego projektowania przepływu aplikacji, jej stanu, rozgałęzień, pętli i kolejnych kroków.
Czy LangChain wykorzystuje LangGraph?
Tak. W aktualnym LangChain agenci tworzeni za pomocą create_agent() są zbudowani na LangGraphie. Dzięki temu LangChain może korzystać z mechanizmów takich jak stan, persistence czy human-in-the-loop.
Czy można używać LangGraph bez LangChain?
Tak. LangGraph może działać niezależnie od LangChain. Możesz budować w nim własne workflow, łączyć zwykły kod Pythona z wywołaniami modeli i samodzielnie kontrolować kolejne kroki.
Do czego służy LangSmith?
LangSmith pomaga obserwować działanie aplikacji AI. Pozwala analizować traces, wywołania modeli i narzędzi, debugować błędy oraz prowadzić ewaluacje i porównywać kolejne wersje systemu.
LangChain czy LangGraph - od czego zacząć?
Jeżeli tworzysz prostego agenta z kilkoma narzędziami, zacznij od LangChain. LangGraph warto dodać wtedy, gdy potrzebujesz większej kontroli nad routingiem, stanem, retry, pętlami lub human-in-the-loop.
Czy LangSmith jest wymagany do korzystania z LangChain?
Nie. LangChain i LangGraph działają bez LangSmith. LangSmith jest dodatkową warstwą przydatną do obserwowalności, debugowania, monitorowania i testowania jakości aplikacji.